学完这章,你能
- 按同一条规则计算像素灰度
- 比较任务规模与准备开销的影响
- 说清CPU、GPU和CUDA各管什么
从一个像素的三个数开始,先算一次平均值。再看相同的小任务怎样排队或并行,不需要先拥有显卡。
先看同一个任务:把每个彩色像素变成灰色。 每个像素可以独立计算,不用等旁边的结果。
先算一个像素
一个像素用红、绿、蓝三个数表示,简称RGB,本例都在0–255之间。
一个彩色像素 · 红、绿、蓝 RGB1 × 3只读
行列索引从 1 开始
本例把三个数取平均,再取最近整数:(84 + 164 + 224) ÷ 3 ≈ 157。红、绿、蓝都用157,就得到一个灰色像素。
再让许多像素一起算
左右使用相同图片、相同灰度规则。轮廓指出这一轮处理的位置;进度记录已经完成多少像素。
并行原理示意 · 程序生成的教学图片 · 动画轮数不是实际耗时
同一张彩色输入每格是一个像素
CPU 示意4 个并行任务通道
GPU 示意32 个并行任务通道
第 0 轮 · 同一条灰度规则,结果应完全相同。
点击播放。CPU 先处理,GPU 先准备,再一次处理更多像素。也可以前进一轮,仔细看哪些像素变灰。
本例使用简单平均法:灰度 =(红 + 绿 + 蓝)÷ 3,再四舍五入。例如 (84 + 164 + 224)÷ 3 ≈ 157。
4 与 32 是教学模型的任务通道数,不是实际 CPU/GPU 的核心规格;本例还假设每个通道每轮完成一个像素。
换一次任务规模,看看谁先完成
- 大图 播放默认的768个像素。GPU先准备,随后一轮处理更多像素。
- 小图 换成4个像素再播放。计入准备过程时,CPU反而先完成。
- 省去模型里的准备 取消“计入GPU准备过程”,重播小图。观察同一任务的结果怎样改变。
CPU也能并行。这里用4个与32个任务通道说明分工,不是硬件核心数,也不是实测速率。
GPU为什么需要准备,真实速度还受什么影响?
提交任务、启动计算可能有成本;独立显存还可能需要传输数据。大批任务能分摊开销,小任务未必划算。数据已在GPU、统一内存等情况,成本也会不同。
真实表现还受任务依赖、内存带宽、数据布局和算法影响;增加并行通道,不会自动解决这些问题。
参考:NVIDIA并行与数据传输指南。
跑代码:只改一个颜色
这段代码核对四种颜色的灰度,不测CPU/GPU速度。
只改第一种颜色,核对对应结果
- 先运行,四个灰度应依次是
157、180、78、142。 - 只把第一种颜色
[84, 164, 224] 改成 [255, 255, 255]:第一个灰度变成 255,其余仍是180、78、142。 - 点“重置”再运行,应恢复原来的四个灰度。
先读绿色注释,再改一个数字,运行后核对结果。
输入时自动提示 · Ctrl + Space 查看补全 · Ctrl / ⌘ + Enter 运行
点击运行,查看结果
还没有运行。先预测结果,再点击运行。
其他灰度算法与真实测速,后面按需查
实际图像处理也会对红绿蓝加权。本节用简单平均,专门看清“每个像素独立计算”的并行关系。
测速时统一输入、算法和精度,先热身;分开记录纯计算和含数据传输的耗时。GPU操作可能异步提交,计时要等待实际执行完成,再记录设备与软件版本。
参考:PyTorch性能调优指南。
这一小步,你看懂了
算法相同,任务安排可以不同。 GPU常擅长大批相似运算;小任务可能更适合CPU。刚才只改一种颜色,也只改变对应结果。
下一节看CPU与GPU怎样合作。
- CPU擅长灵活处理系统、分支判断和任务调度。
- GPU擅长让大量数据并行执行相似运算。
两者能力有重叠,通常按任务合作。
以处理一张图片为例
- CPU准备 读取图片、组织要处理的数据。
- GPU计算 数据就绪后,批量处理像素。
- 继续使用结果 后续程序可以取回结果,也可以继续在GPU上计算。
这是一条常见路径;小任务也可以全在CPU完成。CPU与GPU的分工参考。
APU、FPGA、NPU:遇到时这样区分
- APU:AMD将CPU与GPU集成在同一颗芯片的产品称呼,强调协作。AMD定义。
- FPGA:出厂后还能重新配置逻辑电路,适合定制硬件流水线。Altera介绍。
- NPU:针对神经网络运算优化,常用于降噪、背景虚化等模型推理,具体能力看硬件与软件支持。Intel介绍。
它们可以与CPU、GPU共存,不是必须逐个购买的学习装备。
本节小结
先按任务分工,再选设备。CPU负责通用处理与调度,GPU常负责大批相似计算。 入门阶段用已有电脑继续就好。
硬件负责算,软件负责把计算交给硬件。 以NVIDIA GPU为例:
从你写的代码,到GPU执行
- PyTorch 用张量写出要做的运算,并指定设备。
- CUDA后端与驱动 PyTorch使用适配的计算实现,由软件配合提交工作。
- NVIDIA GPU 执行并行计算,保存结果。
CUDA是NVIDIA的并行计算平台和编程模型,不是一块显卡。有显卡不等于能用CUDA;安装CUDA,也不会让张量自动转到GPU。 设备、驱动与PyTorch环境需要匹配。官方安装说明。
CUDA还提供哪些能力?
它提供并行计算、设备内存与数据传输接口,以及开发工具和优化库。例如cuBLAS服务于线性代数,cuDNN提供深度学习相关运算。
写PyTorch时先使用框架运算;需要自定义底层GPU计算时,再深入CUDA平台与编程指南。
AMD、Intel、Apple:设备名称对照
“后端”可以先理解成框架把运算交给某类设备的一套实现。
- AMD → ROCm:适配设备与环境上的GPU计算生态;ROCm版PyTorch兼容沿用部分
torch.cuda 接口。AMD介绍、PyTorch说明。 - Intel GPU → XPU后端:设备代码中会看到
xpu。PyTorch说明。 - Apple芯片Mac → MPS后端:设备代码中通常写
mps。Apple说明。
按自己设备核对官方支持列表。不同后端的操作支持与表现不保证相同。
认识英伟达:黄仁勋与一张显卡
NVIDIA设计GPU,也建设配套软件生态。黄仁勋于1993年参与创办公司,是联合创始人。官方人物资料。
黄仁勋 · Jensen Huang英伟达联合创始人。
照片:NVIDIA 官方。
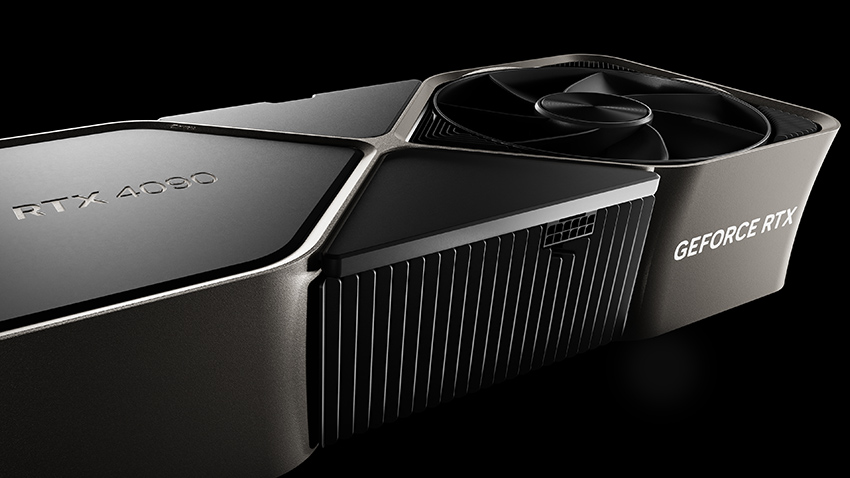
GeForce RTX 4090 · 显卡外观这是一张搭载 GPU 的显卡。可见的风扇、散热结构和接口服务于整张卡,GPU 芯片位于散热器下方。
产品图:NVIDIA 官方图库。
GPU是计算芯片;独立显卡通常还带有显存、电路板、供电与散热。图中的风扇和外壳属于整张卡,GPU芯片在散热器下方。这里用外观认识硬件,不需要先购买它。

